Суть патерна
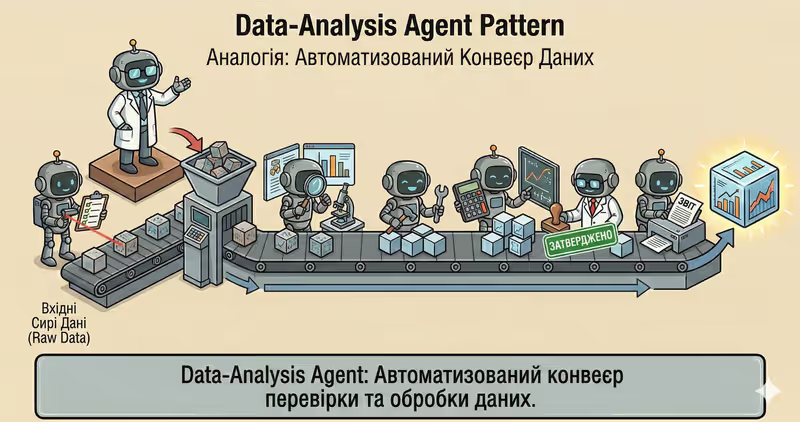
Data-Analysis Agent - це патерн, у якому агент працює з табличними або часовими даними через керований аналітичний пайплайн: policy check, ingest, profile, transform, analyze, validate, report.
Коли потрібен: коли треба порахувати й перевірити метрики на реальних даних, а не описати їх загальними словами.
На відміну від "просто відповісти", агент виконує послідовну аналітику:
Ingest + profile: читає дані та перевіряє їхню якістьTransform: очищує аномалії та пропуски за правиламиAnalyze: рахує метрики, KPI та агрегатиValidate: перевіряє консистентність результатівReport: формує висновки й артефакти для аудиту
Проблема
Уяви, що ти питаєш:
"Скільки ми заробили за минулий тиждень?"
Отримуєш число, але не розумієш, що було зроблено з даними перед розрахунком.
Залишаються критичні питання:
- чи враховані повернення
- чи прибрані дублікати
- як оброблені пропуски
- чи не зникли частини даних під час "очистки"
Аналітика без фіксованого процесу дає числа, які складно пояснити, перевірити і повторити.
Тому той самий датасет різні люди можуть порахувати по-різному.
У цьому й проблема: без прозорого пайплайну результат аналізу стає непередбачуваним і неаудитованим.
Рішення
Data-Analysis Agent працює через фіксований аналітичний пайплайн.
Аналогія: це як лабораторний аналіз. Спочатку беруть зразок і перевіряють його якість, потім рахують показники. Без цієї послідовності цифрам не можна довіряти.
Ключовий принцип: Цінність не лише в числі, а в тому, що кожен крок аналізу можна пояснити й відтворити.
Агент не може "одразу порахувати" - він проходить кроки:
- Перевірка політики: перевірити доступ до джерела
- Завантаження: отримати дані
- Профілювання: перевірити структуру і якість
- Трансформація: очистити за правилами
- Аналіз: порахувати метрики
- Валідація: перевірити результат
І обов'язково фіксує:
- джерело даних
- правила очистки
- виконані перевірки
- обмеження даних
Це дає можливість показати, наприклад:
- які рядки були видалені
- як оброблено пропуски
- які аномалії знайдено
- які інваріанти пройдено
Працює добре, якщо:
- крок завантаження не можна пропустити
- правила очищення зафіксовані
- крок валідації обов'язковий
- шар виконання не дозволяє обходити кроки пайплайну
Надійна аналітика - це пайплайн, який агент технічно не може обійти.
Як працює
Цей патерн часто використовує Code-Execution Agent для запуску обчислень у sandbox.
Ключова різниця: тут фокус не на запуску коду як такому, а на повному аналітичному циклі з контрольними воротами якості.
Опис повного флоу: Policy Check → Ingest → Profile → Transform → Analyze → Validate → Report
Перевірка політики
До обробки система перевіряє джерело, роль доступу й чутливість даних (PII).
Завантаження
Дані завантажуються з фіксацією джерела, періоду й версії.
Профілювання
Агент перевіряє schema, пропуски, дублікати й аномальні значення.
Трансформація
Очищення і нормалізація: типи полів, фільтри, обробка missing values.
Аналіз
Обчислення KPI, агрегатів і порівнянь.
Валідація
Система перевіряє інваріанти: діапазони метрик, відсутність негативних значень, узгодженість агрегатів.
Звіт
Формується результат: таблиці, графіки, ключові висновки та evidence.
У коді це виглядає так
decision = policy_engine.evaluate_source(source, user_role=user_role)
if decision.type != "allow":
    return stop_with_reason("source_policy_denied")

df = load_data(source)
profile = profile_data(df)

if profile.schema_mismatch:
    return stop_with_reason("schema_mismatch")

df_clean = clean_data(df, rules=cleaning_rules)
metrics = compute_metrics(df_clean)

checks = validate_metrics(metrics, rules=[
    "no_negative_revenue",
    "conversion_between_0_1",
])

if not checks.ok:
    return escalate_or_fallback(checks.errors)

report = build_report(metrics, checks, profile)
return report
Аналітичний результат має містити не лише цифри, а й evidence: які перевірки пройдено і які обмеження були в даних.
Як це виглядає під час виконання
Goal: підготувати щотижневий підсумок продажів

Ingest:
- sales.csv за останні 7 днів

Profile:
- 2% пропусків у channel
- 1 аномалія в revenue

Transform:
- заповнення channel = "unknown"
- видалення дубліката id=8472

Analyze:
- revenue: 142,300
- conversion: 3.84%
- top channel: paid_search

Validate:
- усі інваріанти пройдені

Report:
- таблиця KPI + короткі висновки
Повний приклад Data-Analysis агента
Коли підходить — і коли ні
Підходить
| Ситуація | Чому Data-Analysis підходить | |
|---|---|---|
| ✅ | Регулярна аналітика над наборами даних | Патерн добре працює для системної та повторюваної обробки даних. |
| ✅ | Відтворювані метрики | Пайплайн забезпечує стабільність результатів між запусками. |
| ✅ | Перевірки якості обов'язкові перед висновками | Валідації та інваріанти зменшують ризик помилкових інтерпретацій. |
| ✅ | Аудитопридатний результат | Результат та кроки обробки прозорі й придатні до перевірки. |
Не підходить
| Ситуація | Чому Data-Analysis не підходить | |
|---|---|---|
| ❌ | Малий обсяг даних | Ручний аналіз буде простішим і дешевшим. |
| ❌ | Суто текстова задача | Без обчислень і перевірок аналітичний пайплайн зайвий. |
| ❌ | Немає інфраструктури виконання | Без інфраструктури валідацію і відтворюваність не забезпечити. |
Бо Data-Analysis агент потребує додаткової інженерії: пайплайн, перевірки, моніторинг і версіонування джерел.
Чим відрізняється від Code-Execution
| Code-Execution | Data-Analysis | |
|---|---|---|
| Роль | Безпечно виконати код | Повний аналітичний цикл по даних |
| Фокус | sandbox у середовищі виконання і контроль запуску | Якість метрик і аналітичних висновків |
| Output | Результат виконання коду | KPI, перевірки, висновки, звіт |
| Головний ризик | Небезпечне/нестабільне виконання | Некоректна інтерпретація або брудні дані |
Code-Execution - це механізм запуску. Data-Analysis - це процес отримання надійного аналітичного результату.
Коли використовувати Data-Analysis (vs інші патерни)
Використовуйте Data-Analysis, коли потрібно досліджувати дані та повертати висновки на основі аналізу.
Короткий тест:
- якщо потрібно "пояснити, що відбувається в даних, і дати висновки" -> Data-Analysis
- якщо потрібно "просто виконати код і отримати технічний output" -> Code-Execution Agent
Порівняння з іншими патернами та приклади
Швидка шпаргалка:
| Якщо задача виглядає так... | Використовуйте |
|---|---|
| Після кожного кроку треба вирішити, що робити далі | ReAct Agent |
| Спочатку треба розбити велику ціль на менші виконувані задачі | Task Decomposition Agent |
| Потрібно запускати код, перевіряти результати і безпечно ітерувати | Code Execution Agent |
| Потрібно досліджувати дані та повертати висновки на основі аналізу | Data Analysis Agent |
| Потрібне дослідження з кількох джерел зі структурованими доказами | Research Agent |
Приклади:
ReAct: "Знайди причину падіння API: перевір логи -> подивись помилки -> запусти наступну перевірку за результатом".
Task Decomposition: "Підготуй запуск нового тарифу: розбий задачу на підзадачі для контенту, техніки, QA і підтримки".
Code Execution: "Порахуй retention за 12 місяців у Python і перевір коректність формул на реальних даних".
Data Analysis: "Проаналізуй CSV із продажами: знайди тренди, аномалії та дай короткі висновки".
Research: "Збери дані про 5 конкурентів із кількох джерел і зроби порівняльне резюме".
Не впевнені, чи ваш кейс більше про аналіз даних? Спроєктувати Агента →
Як комбінувати з іншими патернами
- Data-Analysis + Code-Execution: коли потрібно рахувати або трансформувати дані, агент запускає код у sandbox з лімітами.
- Data-Analysis + Guarded-Policy: якщо є чутливі дані, політики обмежують, які таблиці та поля можна читати.
- Data-Analysis + Fallback-Recovery: якщо джерело або крок падає, пайплайн переходить на безпечний сценарій відновлення.
Коротко
Data-Analysis Agent:
- Працює з даними через послідовний пайплайн
- Додає перевірки якості до кожного етапу
- Повертає відтворювані метрики і висновки
- Зменшує ризик помилок у бізнес-рішеннях
Переваги та Недоліки
Переваги
швидко обробляє великі обсяги даних
допомагає знаходити тренди й аномалії
результат можна перевірити й повторити
зручно будувати звіти та графіки
Недоліки
без якісних даних висновки будуть слабкими
складні обчислення можуть працювати повільно
потрібна перевірка, щоб не зробити хибний висновок
FAQ
Q: Чи може агент робити аналіз без профілювання даних?
A: Може, але це ризиковано. Без profile-кроку легко пропустити проблеми схеми і зламати метрики.
Q: Навіщо валідувати метрики після розрахунку?
A: Щоб ловити аномалії до відправки результату: негативні revenue, конверсію поза [0,1] та інші інваріанти.
Q: Чи замінює Data-Analysis агент BI-систему?
A: Ні. Він доповнює BI: автоматизує разовий аналіз, очистку і пояснення, але не скасовує data governance (управління даними).
Що далі
Data-Analysis агент працює зі структурованими даними та відтворюваними метриками.
А як побудувати агента для open-world дослідження: пошук джерел, читання, виділення фактів і цитування?