Суть патерна
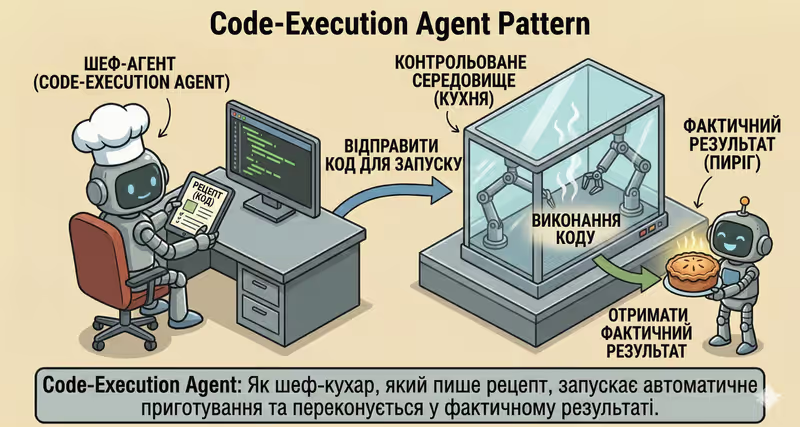
Code-Execution Agent - це патерн, у якому агент не лише міркує текстом, а й запускає згенерований код у контрольованому середовищі, отримує фактичний результат і працює з ним далі.
Коли потрібен: коли відповідь треба обчислити або перевірити запуском коду, а не просто згенерувати текстом.
Агент:
Generate: генерує короткий код під задачуRun: виконує його в sandboxObserve: отримує реальний результатExplain: повертає результат із поясненням
Проблема
Уяви, що ти просиш:
"Порахуй середню конверсію з цього CSV."
Агент пише скрипт і каже: "Середня конверсія - 3.84%".
Але без контрольованого середовища ти не бачиш:
- що саме виконувалось
- які файли читались
- чи були спроби мережевих викликів
- скільки ресурсів спожив код
У виконанні коду важлива не лише логіка коду, а й межі середовища, в якому цей код запускається.
У цьому й проблема: результат залежить одночасно від коду і середовища виконання, тому "просто запустити" небезпечно й непрозоро.
Рішення
Code-Execution Agent запускає код тільки через контрольований шар виконання.
Аналогія: це як лабораторія з технікою безпеки. Експеримент можна робити лише в ізольованій кімнаті й за правилами. Це зменшує ризик пошкодити середовище або витягнути зайві дані.
Ключовий принцип: Модель може написати код, але запуск дозволений лише в sandbox і після перевірки політики.
Базові обмеження:
- sandbox runtime
- обмежений доступ до файлів
- без мережі
- ліміти CPU/RAM/часу
Керований цикл:
- Планування: визначити мінімальний скрипт для задачі
- Генерація: згенерувати код
- Перевірка політики: перевірити безпеку й дозволені операції
- Запуск в ізоляції: виконати код у sandbox
- Перевірка результату: перевірити коректність і ризики результату
Якщо перевірка політики або результату не пройдена, виконання зупиняється або ескалується.
Це захищає від ситуацій, коли агент може:
- читати чутливі файли
- відправляти дані назовні
- зависати на довгих циклах
- виконувати небезпечні операції
Надійне виконання коду - це не "просто запуск", а запуск, який runtime-policy технічно не дає обійти.
Як працює
Ключовий елемент - sandbox.
Зазвичай він обмежує:
файлову систему: доступ лише до робочої директоріїмережу: часто повністю вимкненаресурси:CPU/RAM/time quotasсередовище виконання: дозволені бібліотеки та системні виклики
Опис повного флоу: Plan → Generate Code → Policy Check → Execution Layer → Sandbox Run → Validate → Return
Планування
Агент визначає, що саме треба обчислити і який формат результату очікується.
Генерація коду
Модель генерує мінімальний код під конкретний крок, без зайвого обсягу.
Перевірка політики
Згенерований код проходить policy-engine: дозволені бібліотеки, тип обчислень і допустимий рівень ресурсоємності.
Шар виконання
Система готує контрольоване виконання: середовище, ліміти та правила доступу.
Запуск у sandbox
Код виконується в ізоляції з жорсткими лімітами.
Валідація
Система перевіряє формат результату, помилки, політики безпеки і відповідність очікуваній схемі.
Повернення результату
Користувач отримує валідну відповідь або контрольовану зупинку/ескалацію.
У коді це виглядає так
code = agent.generate_code(goal, constraints={
    "language": "python",
    "no_network": True,
    "max_seconds": 5,
})

exec_result = execution_layer.run_code(
    code=code,
    policy="sandboxed_python",
)

if not exec_result.success:
    return fallback_or_stop(exec_result.error)

validated = validate_output(exec_result.stdout, schema=expected_schema)
if not validated.ok:
    return stop_with_reason(validated.reason)

return format_answer(validated.data)
Головне правило: ніколи не виконувати згенерований код поза sandbox та policy-контролем.
Як це виглядає під час виконання
Goal: порахувати конверсію по CSV-звіту

Generate Code:
- читання sales.csv
- обчислення conversion_rate = paid / leads
- вивід таблиці по днях

Sandbox Run:
- timeout: 5s
- memory: 256MB
- network: disabled

Output:
- таблиця з 7 рядків
- середня конверсія: 3.84%
Повний приклад Code-Execution агента
Коли підходить — і коли ні
Підходить
| Ситуація | Чому Code-Execution підходить | |
|---|---|---|
| ✅ | Потрібні реальні обчислення, а не текстові припущення | Виконання коду дає фактичний результат замість здогадок моделі. |
| ✅ | Робота з таблицями, файлами, формулами | Тут потрібен фактичний запуск кроків, а не лише текстовий опис. |
| ✅ | Важлива відтворюваність результату | Запуск у контрольованому середовищі виконання робить перевірку результатів простішою. |
| ✅ | Є sandbox + примусове застосування політик | Безпечна інфраструктура дозволяє виконувати код без критичних ризиків. |
Не підходить
| Ситуація | Чому Code-Execution не підходить | |
|---|---|---|
| ❌ | Суто текстова задача | Запуск коду додає зайву складність без користі. |
| ❌ | Немає ізольованого середовища виконання | Без sandbox неможливо безпечно виконувати згенерований код. |
| ❌ | Ризик вищий за користь | Потенційна шкода не виправдовує підхід виконання у цьому кейсі. |
Бо виконання коду додає операційні вимоги: sandbox, ліміти ресурсів, моніторинг і аудит запусків.
Чим відрізняється від Guarded-Policy
| Guarded-Policy | Code-Execution | |
|---|---|---|
| Головний фокус | Що дозволено виконувати | Як безпечно виконати згенерований код |
| Ключовий механізм | Policy gate | Sandbox runtime + output validation |
| Коли спрацьовує | Перед дією | Під час і після запуску коду |
| Ризик без патерна | Небезпечна дія потрапить у виконання | Ненадійні або небезпечні результати виконання |
Guarded-Policy вирішує, чи взагалі можна діяти. Code-Execution вирішує, як безпечно і відтворювано виконати кодову дію.
Коли використовувати Code-Execution (vs інші патерни)
Використовуйте Code-Execution, коли агент має запускати код, перевіряти результати і безпечно ітерувати.
Короткий тест:
- якщо потрібно "виконати код і працювати з фактичним output" -> Code-Execution
- якщо потрібно "спершу лише розбити велику задачу на підзадачі" -> Task Decomposition Agent
Порівняння з іншими патернами та приклади
Швидка шпаргалка:
| Якщо задача виглядає так... | Використовуйте |
|---|---|
| Після кожного кроку треба вирішити, що робити далі | ReAct Agent |
| Спочатку треба розбити велику ціль на менші виконувані задачі | Task Decomposition Agent |
| Потрібно запускати код, перевіряти результати і безпечно ітерувати | Code Execution Agent |
| Потрібно досліджувати дані та повертати висновки на основі аналізу | Data Analysis Agent |
| Потрібне дослідження з кількох джерел зі структурованими доказами | Research Agent |
Приклади:
ReAct: "Знайди причину падіння API: перевір логи -> подивись помилки -> запусти наступну перевірку за результатом".
Task Decomposition: "Підготуй запуск нового тарифу: розбий задачу на підзадачі для контенту, техніки, QA і підтримки".
Code Execution: "Порахуй retention за 12 місяців у Python і перевір коректність формул на реальних даних".
Data Analysis: "Проаналізуй CSV із продажами: знайди тренди, аномалії та дай короткі висновки".
Research: "Збери дані про 5 конкурентів із кількох джерел і зроби порівняльне резюме".
Не впевнені, чи тут справді потрібен запуск коду? Спроєктувати Агента →
Як комбінувати з іншими патернами
- Code-Execution + Guarded-Policy: перед запуском агент перевіряє код за правилами безпеки і блокує небезпечні дії.
- Code-Execution + Fallback-Recovery: якщо виконання зависло або впало з помилкою, агент переходить на безпечний резервний сценарій.
- Code-Execution + Supervisor: ризикові запуски агент не виконує сам, а передає на погодження людині.
Коротко
Code-Execution Agent:
- Генерує код під конкретну задачу
- Виконує його в ізольованому sandbox
- Валідовує результат перед відповіддю
- Підвищує точність у задачах з обчисленнями
Переваги та Недоліки
Переваги
дає точніші результати в обчисленнях
результат легко перевірити й повторити
видно, який код і що саме запускалось
зручно працювати з файлами та даними
Недоліки
потрібне ізольоване середовище
через запуск коду відповідь може бути повільнішою
можливі помилки під час виконання коду
FAQ
Q: Чи можна виконувати код просто на сервері без ізольованого середовища?
A: Для продакшну: ні. Потрібна ізоляція, ліміти ресурсів і контроль дозволених операцій.
Q: Чи гарантує виконання коду правильність результату?
A: Не повністю. Потрібні валідація результату, тести на інваріанти і перевірка політик.
Q: Що робити, якщо код падає під час виконання?
A: Застосовувати обмежене відновлення: retry, резервне середовище виконання або контрольовану зупинку зі stop reason.
Що далі
Code-Execution підхід дозволяє агенту надійно виконувати обчислення.
А як застосувати це для повноцінної аналітики: очистки даних, агрегатів, графіків і висновків?